
मल्टीमॉडल एआई को समझना: पाठ, छवि और आवाज का एकीकरण
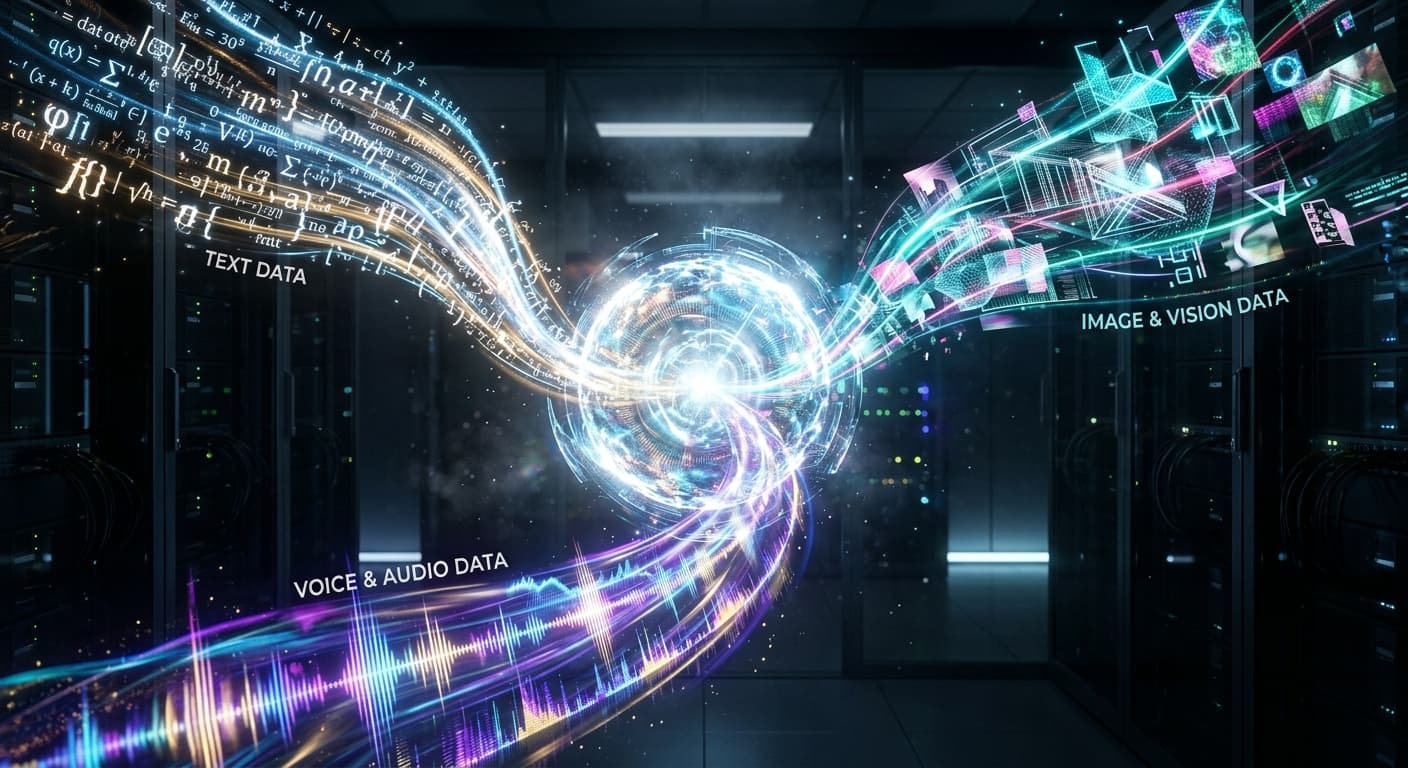
मल्टीमोडल एआई को समझना: पाठ, छवि और आवाज का संयोजन
कृत्रिम बुद्धिमत्ता की तेजी से विकसित होती दुनिया में, मल्टीमोडल एआई एक क्रांतिकारी विकास के रूप में उभरता है। विभिन्न प्रकार के डेटा—पाठ, छवियाँ, और आवाज़ों—को एकीकृत करके, यह तकनीक जानकारी की एक अधिक समग्र समझ बनाती है, जो उद्योगों में नवीनतम अनुप्रयोगों के लिए रास्ता खोलती है। इस लेख में, हम मल्टीमोडल एआई के सिद्धांत, इसके महत्व और इसके अनुप्रयोगों की खोज करेंगे।
मल्टीमोडल एआई क्या है?
मल्टीमोडल एआई उन प्रणालियों को संदर्भित करता है जो एक साथ कई प्रकार के डेटा को संसाधित और विश्लेषण करने के लिए डिज़ाइन की गई हैं। पारंपरिक एआई मॉडलों के विपरीत, जो सामान्यतः एक ही प्रकार के इनपुट, जैसे कि पाठ या छवियों पर ध्यान केंद्रित करते हैं, मल्टीमोडल एआई विभिन्न रूपों को एकीकृत करने की क्षमता रखता है, जिससे समझ में वृद्धि होती है और अधिक बारीकियों वाले आउटपुट उत्पन्न होते हैं। यह क्षमता समृद्ध इंटरैक्शन की अनुमति देती है, जिससे एआई सिस्टम वास्तविक जीवन परिदृश्यों में अधिक बहुपरकार और प्रभावी हो जाते हैं।
मल्टीमोडल एआई का महत्व
पाठ, छवियों और आवाज़ों का संयोजन संदर्भ और अर्थ की गहरी समझ को सक्षम बनाता है। उदाहरण के लिए, एक वर्चुअल असिस्टेंट पर विचार करें जो बोलने वाले आदेशों (आवाज), छवियों को पहचान (दृश्य) कर सकता है, और टेक्स्ट प्रारूप में संदर्भ जानकारी प्रदान कर सकता है। यह तालमेल अधिक सहज उपयोगकर्ता अनुभव का परिणाम देता है, जो अधिक जटिल पूछताछ और समृद्ध इंटरैक्शन की अनुमति देता है।
मल्टीमोडल एआई कैसे काम करता है
मल्टीमोडल एआई प्रणाली विभिन्न स्रोतों से डेटा को संसाधित और एकीकृत करने के लिए विभिन्न तकनीकों का उपयोग करते हैं। यहाँ कुछ प्रमुख घटक हैं:
- डेटा अधिग्रहण: पहला चरण विभिन्न रूपों से डेटा جمع करना है, जिसमें पाठ, छवियाँ, और ऑडियो शामिल हो सकते हैं। यह डेटा अक्सर विभिन्न स्रोतों, जैसे इंटरनेट, डेटाबेस, या उपयोगकर्ता इनपुट्स से एकत्र किया जाता है।
- विशेषता निष्कर्षण: प्रत्येक रूप के लिए विशेष तकनीकों की आवश्यकता होती है। पाठ के लिए, प्राकृतिक भाषा प्रसंस्करण (NLP) का उपयोग किया जाता है, जबकि छवियों पर कंप्यूटर दृश्य तकनीकों को लागू किया जाता है, और आवाज़ डेटा के लिए ऑडियो प्रसंस्करण विधियाँ इस्तेमाल की जाती हैं।
- रूपों का संयोजन: एक बार विशेषताएँ निकाली जाने के बाद, अगला चरण उन्हें एकीकृत प्रतिनिधित्व में संयोजित करना होता है। इसे विभिन्न तरीकों से प्राप्त किया जा सकता है, जिनमें संयोजन, ध्यान तंत्र, या अधिक जटिल न्यूरल नेटवर्क आर्किटेक्चर शामिल हैं जो क्रॉस-मोडल इंटरैक्शन की अनुमति देते हैं।
- मॉडल प्रशिक्षण: संलिष्ट डेटा को फिर मशीन लर्निंग मॉडल को प्रशिक्षित करने के लिए उपयोग किया जाता है। ये मॉडल विभिन्न रूपों के बीच पैटर्न पहचानना सीखते हैं, जिससे उन्हें एकीकृत इनपुट के आधार पर भविष्यवाणियाँ या प्रतिक्रियाएँ उत्पन्न करने की अनुमति मिलती है।

