Entendiendo la IA multimodal: la fusión de texto, imagen y voz
Entendiendo la IA Multimodal: La Fusión de Texto, Imagen y Voz
En el mundo en rápida evolución de la inteligencia artificial, la IA multimodal destaca como un desarrollo revolucionario. Al integrar varios tipos de datos—texto, imágenes y voz—esta tecnología crea una comprensión más holística de la información, allanando el camino para aplicaciones innovadoras en diversas industrias. En este artículo, exploraremos el concepto de IA multimodal, su importancia y sus aplicaciones.
¿Qué es la IA Multimodal?
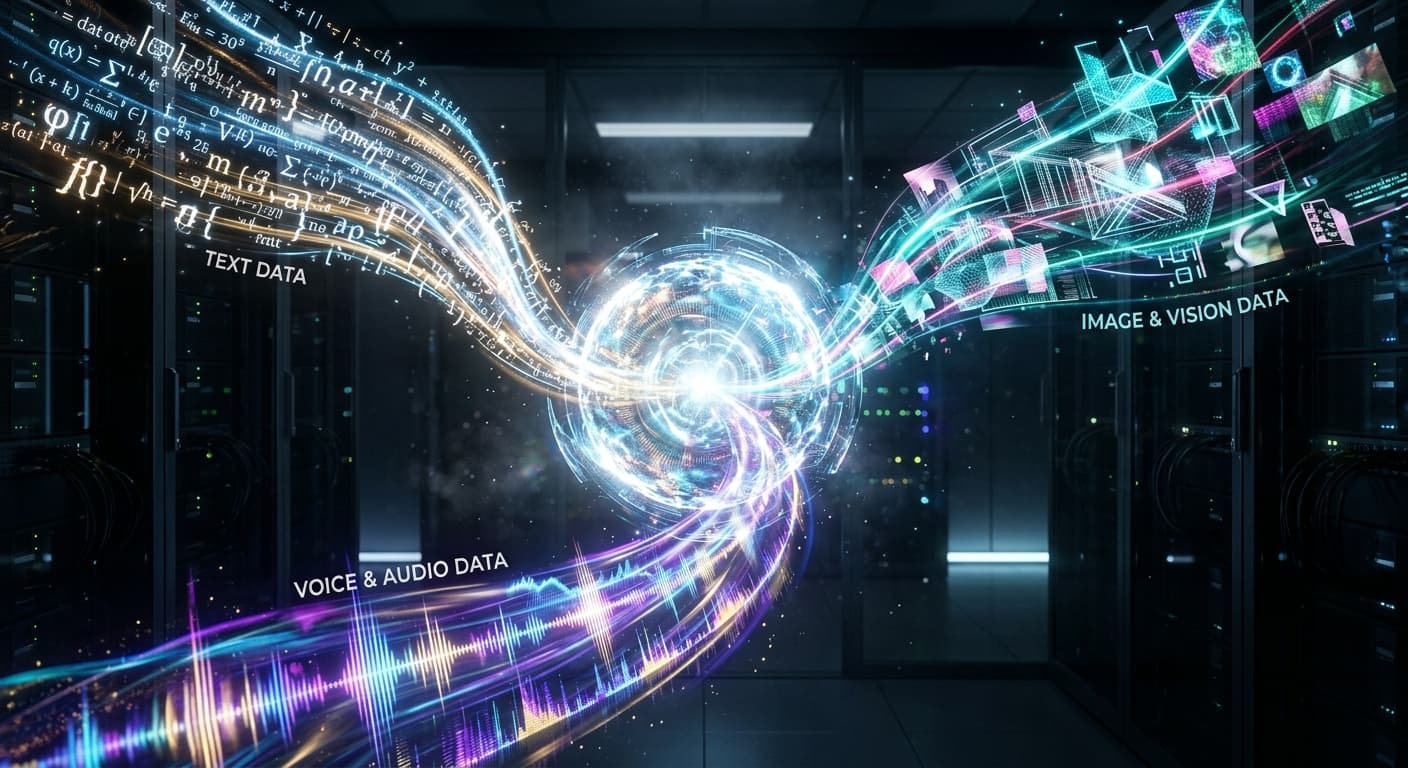
La IA multimodal se refiere a sistemas diseñados para procesar y analizar múltiples tipos de datos simultáneamente. A diferencia de los modelos de IA tradicionales que suelen centrarse en un solo tipo de entrada, como texto o imágenes, la IA multimodal puede combinar diferentes modalidades para mejorar la comprensión y generar resultados más matizados. Esta capacidad permite interacciones más enriquecedoras, haciendo que los sistemas de IA sean más versátiles y efectivos en escenarios del mundo real.
La Importancia de la IA Multimodal
La fusión de texto, imágenes y voz permite una comprensión más profunda del contexto y el significado. Por ejemplo, considere un asistente virtual que puede interpretar comandos hablados (voz), reconocer imágenes (visual) y proporcionar información contextual en forma de texto. Esta sinergia resulta en una experiencia de usuario más intuitiva, permitiendo consultas más complejas e interacciones más ricas.
Cómo Funciona la IA Multimodal
Los sistemas de IA multimodal utilizan diversas técnicas para procesar e integrar datos de diferentes fuentes. Aquí hay algunos componentes clave:
- Adquisición de Datos: El primer paso implica recopilar datos de diferentes modalidades, que pueden incluir texto, imágenes y audio. Estos datos a menudo se recogen de diversas fuentes, como internet, bases de datos o entradas de usuarios.
- Extracción de Características: Cada modalidad requiere técnicas específicas para la extracción de características. Para el texto, se utiliza el procesamiento de lenguaje natural (NLP), mientras que se aplican técnicas de visión por computadora a las imágenes, y se utilizan métodos de procesamiento de audio para los datos de voz.
- Fusión de Modalidades: Una vez extraídas las características, el siguiente paso es combinarlas en una representación unificada. Esto se puede lograr mediante varios métodos, incluyendo la concatenación, mecanismos de atención o arquitecturas de redes neuronales más sofisticadas que permiten interacciones entre modalidades.