
Wie Diffusionsmodelle die Bildgenerierung mit KI beeinflussen
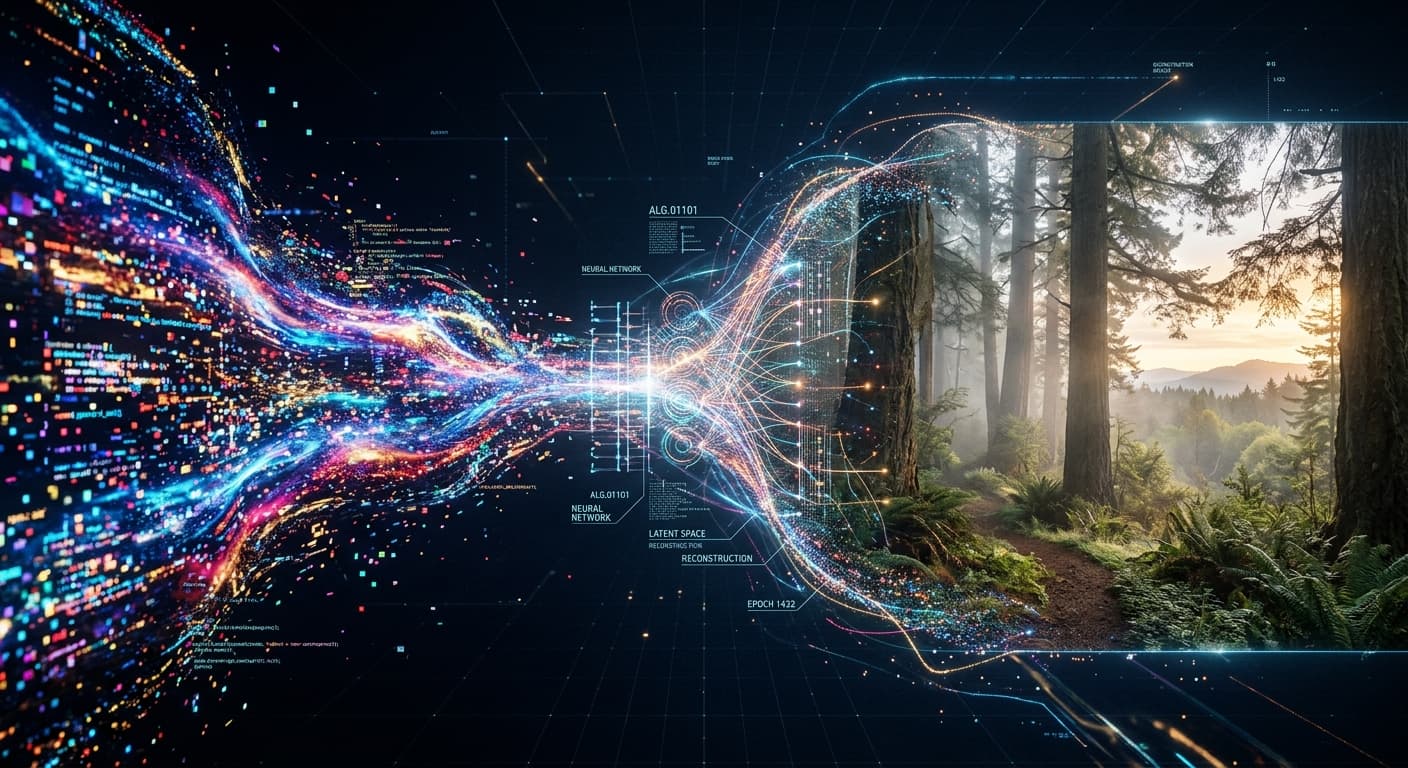
Wie KI-Bilderzeugung funktioniert: Diffusionsmodelle erklärt
Künstliche Intelligenz (KI) in der Bilderzeugung hat die Art und Weise, wie wir visuelle Inhalte erstellen und mit ihnen interagieren, revolutioniert. Von der Erstellung von Kunst bis hin zur Erzeugung realistischer Bilder hat KI in den letzten Jahren bedeutende Fortschritte gemacht. Im Mittelpunkt dieser Revolution stehen Diffusionsmodelle, die die Landschaft der generativen KI neu gestalten. In diesem Artikel werden wir untersuchen, wie Diffusionsmodelle funktionieren, welche Anwendungen sie haben und was sie zu einem Grundpfeiler der modernen KI-Bilderzeugung macht.
Was sind Diffusionsmodelle?
Diffusionsmodelle sind eine Klasse von generativen Modellen, die zufälliges Rauschen in zusammenhängende Bilder umwandeln. Sie arbeiten nach dem Prinzip, Rauschen schrittweise zu einem strukturierten Bild zu verfeinern. Diese Methode ähnelt der Umkehrung eines Diffusionsprozesses – daher der Name.
Der Prozess lässt sich in zwei Hauptphasen unterteilen: den Vorwärtsdiffusionsprozess und den Rückwärtsdiffusionsprozess.
Vorwärtsdiffusionsprozess
Im Vorwärtsprozess wird ein Bild schrittweise durch das Hinzufügen von Rauschen in kleinen Mengen beschädigt. Dieser Prozess verwandelt ein sauberes Bild über eine Reihe von Schritten in eine völlig rauschende Version. Der Schlüssel hierbei ist, dass jeder Schritt von einer mathematischen Funktion gesteuert wird, die bestimmt, wie viel Rauschen hinzugefügt wird. Diese Phase ermöglicht es dem Modell, zu lernen, wie es mit verschiedenen Bildtypen und deren inhärentem Rauschen umgeht.
Rückwärtsdiffusionsprozess
Im Rückwärtsdiffusionsprozess geschieht die Magie. Ausgehend von reinem Rauschen entfernt das Modell iterativ Rauschen, um das ursprüngliche Bild wiederherzustellen. Jeder Schritt in diesem Prozess umfasst die Vorhersage des Rauschens, das subtrahiert werden sollte, was effektiv den Übergang vom zufälligen Rauschen zu einem zusammenhängenden Bild vollzieht. Dies wird erreicht durch das Training auf einem umfangreichen Datensatz von Bildern, wodurch das Modell die grundlegenden Muster und Strukturen visueller Daten erlernen kann.
Schlüsselkomponenten von Diffusionsmodellen
Mehrere Komponenten sind entscheidend für das effektive Funktionieren von Diffusionsmodellen:
- Rauschzeitplanung: Die Rate und Art, wie Rauschen hinzugefügt und entfernt wird, werden durch einen Zeitplan für Rauschen definiert. Dieser Zeitplan ist entscheidend, um sicherzustellen, dass das Modell effektive Darstellungen der Daten lernt.
- Neuronale Netzwerke: Typischerweise verwenden Diffusionsmodelle tiefe neuronale Netzwerke, oft konvolutionale Netzwerke, um die Rauschen-Einschätzung durchzuführen. Diese Netzwerke werden trainiert, um das Rauschen vorherzusagen, das in jedem Schritt hinzugefügt wird.
- Trainingsdaten: Ein vielfältiger und umfangreicher Datensatz ist entscheidend für das Training von Diffusionsmodellen. Die Qualität der Eingabedaten beeinflusst direkt die Qualität der erzeugten Bilder.
Anwendungen von Diffusionsmodellen
Diffusionsmodelle haben mehrere praktische Anwendungen in verschiedenen Bereichen:
- Kunstgenerierung: Künstler und Designer nutzen Diffusionsmodelle, um einzigartige Kunstwerke zu schaffen, oft durch die Kombination menschlicher Kreativität mit maschinell erzeugten Eingaben.
- Bildrestaurierung: Diese Modelle können verwendet werden, um beschädigte oder niedrigauflösende Bilder wiederherzustellen, indem verlorene Details rekonstruiert und die Gesamtklarheit verbessert wird.
- Inhaltserstellung: In Marketing und Werbung unterstützen Diffusionsmodelle die Generierung hochqualitativer visuelle Inhalte für Kampagnen und sparen Zeit und Ressourcen.
- Virtuelle Realität und Gaming: Sie tragen zur Erstellung realistischer Texturen und Umgebungen in virtuellen Settings bei und verbessern das Benutzererlebnis.
Vorteile von Diffusionsmodellen
Diffusionsmodelle bieten mehrere Vorteile im Vergleich zu traditionellen generativen Modellen:
- Hohe Ausgabequalität: Sie sind in der Lage, Bilder mit hoher Treue und Detailgenauigkeit zu erzeugen und übertreffen oft andere Methoden in der Realitätsnähe.
- Robustheit: Diffusionsmodelle sind tendenziell stabiler während des Trainings und weniger anfällig für Probleme wie den Modus-Kollaps, der bei Modellen wie GANs (Generative Adversarial Networks) auftreten kann.
- Flexibilität: Sie können für verschiedene Aufgaben über die Bilderzeugung hinaus angepasst werden, wie z.B. die Videoerzeugung und die Audiokodierung.
Herausforderungen und Zukunftsperspektiven
Obwohl Diffusionsmodelle bemerkenswerte Fortschritte gemacht haben, sind sie nicht ohne Herausforderungen. Der Trainingsprozess kann rechenintensiv sein und erfordert erhebliche Ressourcen. Zudem müssen die Modelle Qualität und Vielfalt in den erzeugten Ausgaben balancieren, was eine komplexe Aufgabe sein kann.
In Zukunft erkunden Forscher Möglichkeiten, die Effizienz von Diffusionsmodellen zu verbessern, die Trainingszeiten zu verkürzen und ihre Fähigkeiten in verschiedenen Bereichen zu erweitern. Innovationen in Architekturen und Trainingsmethoden könnten in Zukunft zu noch leistungsstärkeren generativen Modellen führen.
Wichtige Erkenntnisse
- Diffusionsmodelle erzeugen Bilder, indem sie einen Rauschprozess umkehren und zufälliges Rauschen schrittweise in zusammenhängende Bilder verfeinern.
- Der Vorwärtsdiffusionsprozess beschädigt Bilder, während der Rückwärtsprozess sie rekonstruiert.
- Anwendungen reichen von Kunst, Bildrestaurierung, Inhaltserstellung und mehr.
- Vorteile sind hohe Ausgabequalität, Robustheit und Flexibilität.
FAQ
Q1: Wie unterscheiden sich Diffusionsmodelle von GANs? A1: Im Gegensatz zu GANs, die auf antagonistischen Training zwischen zwei Netzwerken beruhen, verwendet das Diffusionsmodell ein einzelnes Netzwerk, um Rauschen zu schätzen und zu entfernen, was sie während des Trainings stabiler macht.
Q2: Können Diffusionsmodelle auch für andere Aufgaben als die Bilderzeugung verwendet werden? A2: Ja, Diffusionsmodelle können für verschiedene Aufgaben angepasst werden, einschließlich Videoerzeugung und Audiokodierung, was ihre Vielseitigkeit in der generativen KI zeigt.
Q3: Wie hoch sind die rechnerischen Anforderungen für das Training von Diffusionsmodellen? A3: Das Training von Diffusionsmodellen kann ressourcenintensiv sein und erfordert oft leistungsstarke GPUs und umfangreiche Datensätze, um qualitativ hochwertige Ausgaben zu erzielen.
Zusammenfassend sind Diffusionsmodelle ein bedeutender Fortschritt in der KI-Bilderzeugung, der ein robustes Framework für die Erstellung hochwertiger visueller Inhalte bietet. Da die Forschung weiter voranschreitet, können wir auch in diesem aufregenden Bereich mit noch innovativeren Anwendungen und Verbesserungen rechnen. Bei Clever AI widmen wir uns der Erkundung der Grenzen der KI-Technologie und ihrer Auswirkungen auf verschiedene Branchen.