
Feinabstimmung vs. kontextbasiertes Lernen: Wann verwenden?
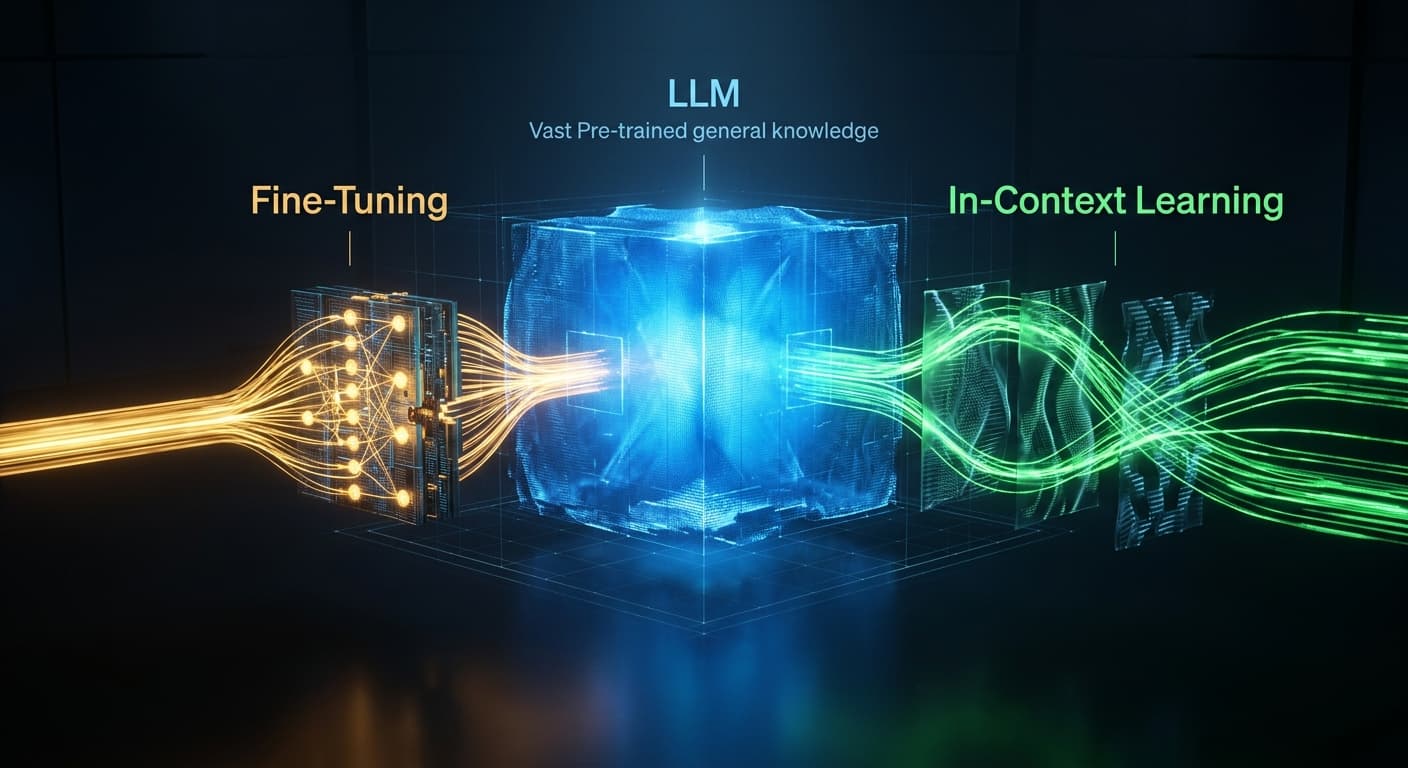
Feinabstimmung vs. Kontextlernen: Wann man was verwenden sollte
Künstliche Intelligenz (KI) entwickelt sich in atemberaubendem Tempo, insbesondere im Bereich der Verarbeitung natürlicher Sprache (NLP). In diesem Bereich sind zwei wesentliche Techniken—Feinabstimmung und Kontextlernen—als Schlüsselstrategien zur Verbesserung der Leistung großer Sprachmodelle (LLMs) entstanden. Das Verständnis der Unterschiede zwischen diesen Ansätzen, ihren Anwendungen und wann man jeden verwenden sollte, kann Fachleuten helfen, fundierte Entscheidungen für ihre KI-Projekte zu treffen.
Was ist Feinabstimmung?
Feinabstimmung ist ein Prozess, bei dem ein vortrainiertes Modell auf einem spezifischen Datensatz weiter trainiert wird, um es an eine bestimmte Aufgabe anzupassen. Diese Methode ermöglicht es dem Modell, das allgemeine Wissen, das es während seines anfänglichen Trainings erlangt hat, zu nutzen und sich auf spezifische Anwendungen zu spezialisieren.
Wichtige Merkmale der Feinabstimmung:
- Spezialisierung: Die Feinabstimmung ändert die Gewichte des Modells basierend auf dem neuen Datensatz und ermöglicht es ihm, die Nuancen und spezifischen Anforderungen einer bestimmten Aufgabe zu lernen.
- Datenabhängigkeit: Sie erfordert eine erhebliche Menge an aufgabenspezifischen Daten, um eine optimale Leistung zu erzielen.
- Rechenintensiv: Die Feinabstimmung kann ressourcenintensiv sein und erfordert erhebliches Rechenvermögen und Zeit.
Feinabstimmung ist besonders effektiv in Szenarien, in denen die betreffende Aufgabe gut definiert ist und ausreichende Daten zur Verfügung stehen. Beispielsweise, wenn Sie möchten, dass ein Modell im Sentiment-Analyse im Bereich Kundenbewertungen der Technologiebranche hervorragend abschneidet, kann die Feinabstimmung eines allgemeinen LLM auf einem kuratierten Datensatz von Tech-Bewertungen beeindruckende Ergebnisse liefern.
Was ist Kontextlernen?
Kontextlernen hingegen bezieht sich auf die Fähigkeit des Modells, Aufgaben basierend auf Beispielen zu verstehen und auszuführen, die im Eingabeaufforderung bereitgestellt werden, ohne seine internen Gewichte zu ändern. Dieser Ansatz nutzt das bereits vorhandene Wissen und die Fähigkeiten des Modells.

