
الضبط الدقيق مقابل التعلم في السياق: متى تستخدم كل منهما
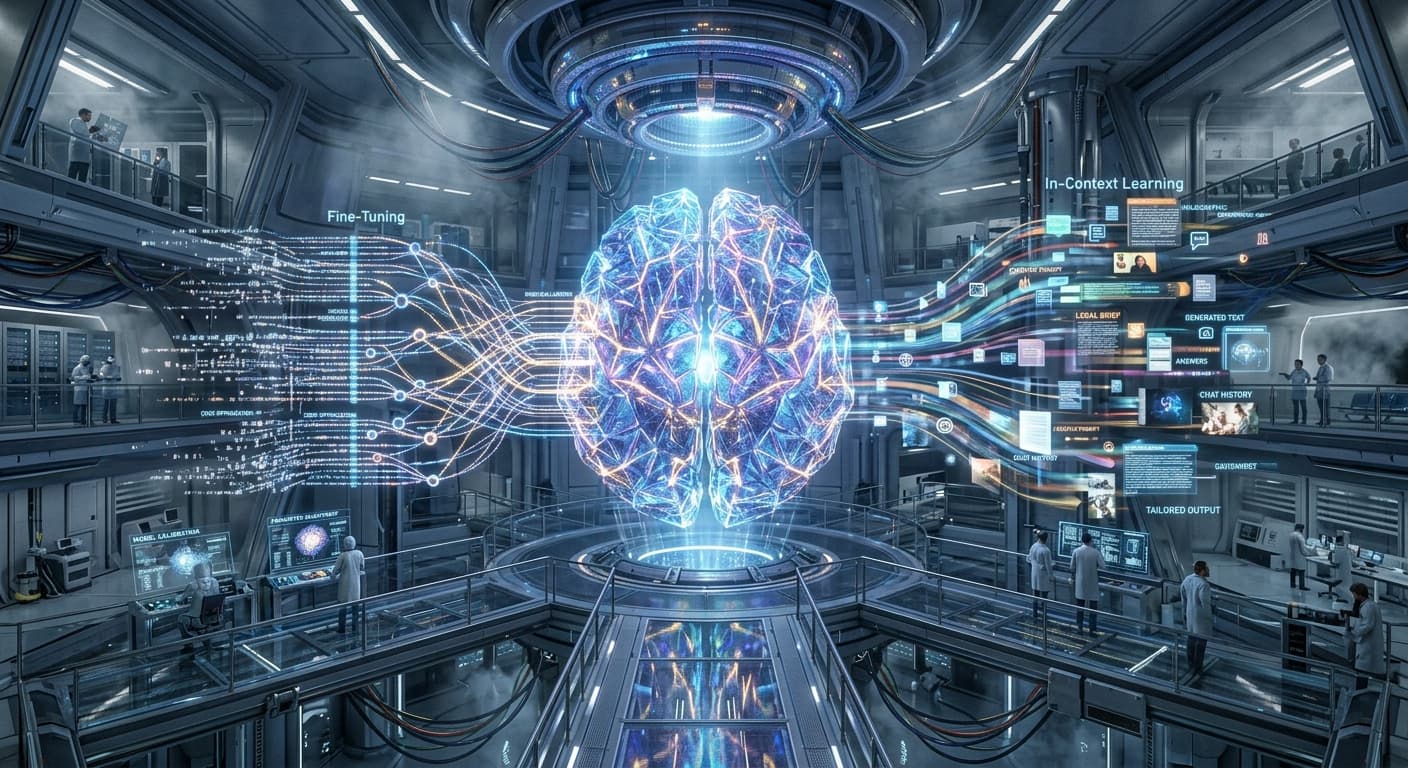
ضبط النماذج مقابل التعلم في السياق: متى تستخدم كل منهما
في المجال سريع التطور للذكاء الاصطناعي، وخاصة مع النماذج اللغوية الكبيرة (LLMs)، فإن فهم التقنيات المتاحة لتحسين أداء النموذج أمر بالغ الأهمية. تسترعي انتباهنا استراتيجيتان بارزتان: الضبط و التعلم في السياق. لكل من النهجين نقاط قوته الفريدة وحالات استخدامه المثلى، مما يجعل من الضروري للمهنيين في مجال الذكاء الاصطناعي فهم الفروق بينهما وتطبيقاتهما.
فهم الضبط
الضبط هو عملية يتم فيها تدريب نموذج مدرب مسبقًا بشكل إضافي على مجموعة بيانات معينة لتكييفه مع مهام أو مجالات معينة. تعدل هذه الطريقة معلمات النموذج لتناسب بشكل أفضل تميّز البيانات الجديدة، مما يعزز أدائه في تطبيقات محددة.
الخصائص الرئيسية للضبط:
- عملية التدريب: تتضمن تغيير أوزان النموذج بناءً على بيانات التدريب الجديدة.
- متطلبات البيانات: تتطلب كمية كبيرة من البيانات المعلّمة ذات الصلة بالمهمة المستهدفة.
- الوقت والموارد: تتطلب بشكل عام موارد حاسوبية أكبر ووقت أكثر مقارنةً بالتعلم في السياق.
- الأداء: تميل إلى تحقيق دقة أعلى في المهمة المستهدفة بسبب تكيف النموذج مع البيانات المحددة.
يكون الضبط مفيدًا بشكل خاص في السيناريوهات التي تكون فيها المهمة محددة جيدًا، والبيانات الكافية متاحة. على سبيل المثال، إذا كنت تطور ذكاءً اصطناعيًا يحتاج إلى فهم المصطلحات القانونية، فإن ضبط نموذج لغة عام على مجموعة من الوثائق القانونية يمكن أن يعزز أدائه بشكل كبير.
التعلم في السياق مشروح
التعلم في السياق هو تقدم أكثر حداثة يسمح للنماذج بأداء المهام من خلال تكييفها على أمثلة يقدمها المستخدم في الطلب دون تغيير أوزانها الداخلية. هذه التقنية تستفيد من قدرة النموذج على فهم وتوليد الاستجابات بناءً على السياق المقدم في وقت الاستدلال.
الخصائص الرئيسية للتعلم في السياق:
- مبني على الطلب: يتضمن تقديم بعض الأمثلة (أو بدون أمثلة) مباشرة في الطلب المدخل.
- عدم تغيير الأوزان: تظل أوزان النموذج دون تغيير خلال هذه العملية.
- المرونة: قابلة للتكيف بشدة مع مهام متنوعة دون الحاجة إلى إعادة تدريب شاملة.
- كفاءة البيانات: تتطلب بيانات أقل وغالباً ما يمكن أن تعمل فقط مع بضع أمثلة لتحقيق أداء معقول.

