Токенизация и контекстные окна: понимание предельной длины в искусственном интеллекте
Токенизация и контекстные окна: понимание ограничений длины в ИИ
В области искусственного интеллекта, особенно в крупных языковых моделях (LLM), концепции токенизации и контекстных окон играют критическую роль в формировании работы этих моделей. Понимание этих концепций не только улучшает наше понимание функциональности ИИ, но и проливает свет на присущие ограничения, с которыми сталкиваются эти системы. Эта статья погружается в тонкости токенизации и контекстных окон, исследуя, почему существуют ограничения по длине и как они влияют на производительность LLM.
Что такое токенизация?
Токенизация — это процесс разбивки текста на более мелкие единицы, известные как токены. Эти токены могут быть как маленькими, так и отдельными символами, так и большими, как целые слова или фразы. Метод токенизации влияет на то, насколько эффективно языковая модель может учиться и генерировать текст.
- Типы токенов: Токены могут значительно различаться в зависимости от используемой стратегии токенизации. Например, некоторые модели используют токенизацию на основе подслов, которая разбивает слова на более мелкие компоненты, позволяя модели обрабатывать более широкий словарный запас и одновременно уменьшая общее количество токенов.
- Важность в ИИ: Токенизация имеет решающее значение для преобразования текста, читаемого человеком, в формат, который можно обрабатывать алгоритмами машинного обучения. Она помогает в понимании семантического значения и контекста текста.
Что такое контекстные окна?
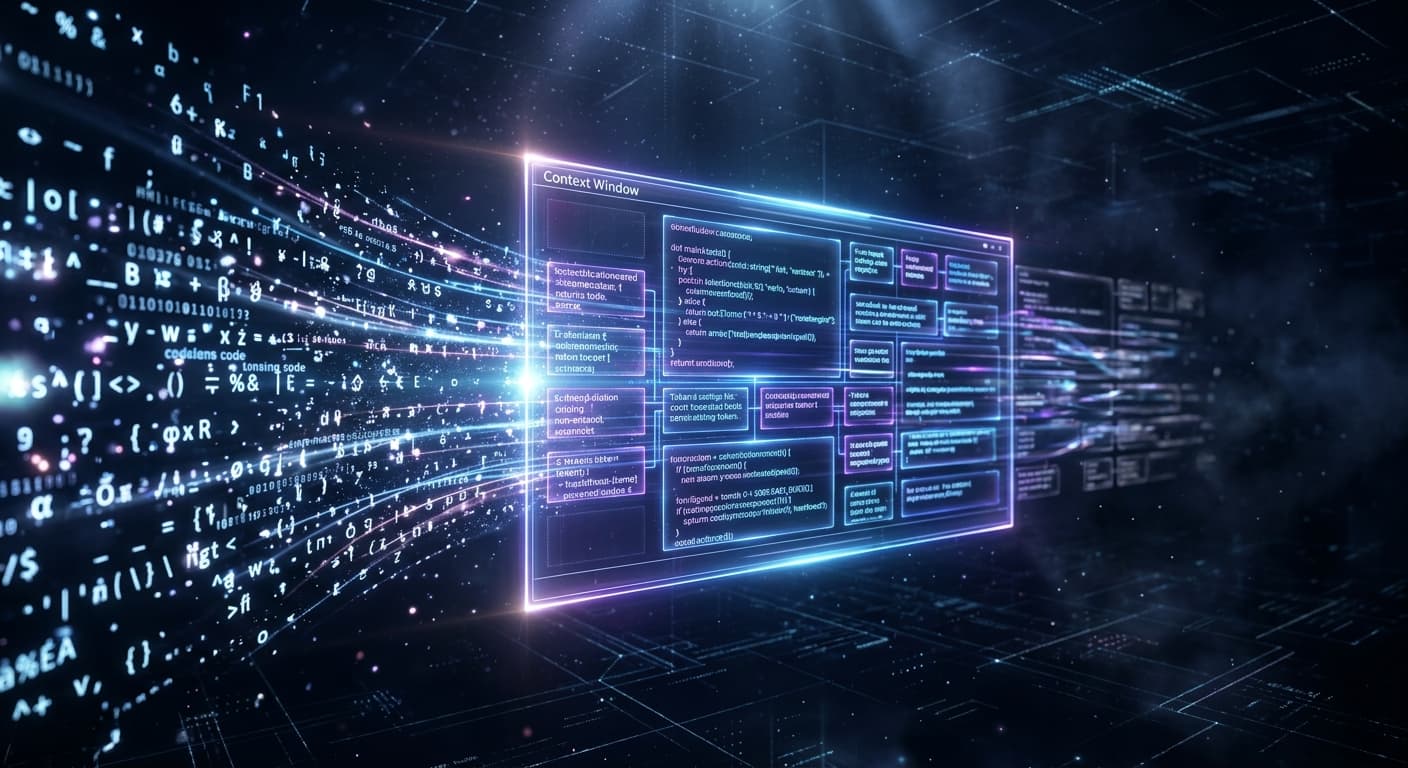
Контекстное окно — это часть текста, которую LLM может учитывать в любой момент времени при генерации ответов или прогнозировании. Это окно определяется определенным лимитом токенов, который варьируется в зависимости от различных моделей. Контекстное окно фактически определяет, сколько предыдущей информации модель может использовать для информирования своих выводов.